Gonka выступила с лекцией в Беркли: о чём студенты спрашивали про децентрализованный ИИ?
Сооснователи Gonka Анастасия Матвеева и Глеб Моргачёв рассказали о Gonka как о децентрализованном протоколе вычислений для ИИ — зачем он нужен, какие проблемы решает, как выглядит децентрализованный инференс и почему важно уметь проверять вычисления.
В начале лекции спикеры отметили, что хотели бы поговорить шире — не обязательно только о самой Gonka, а о децентрализации ИИ в целом.
Особенно их интересуют открытые инженерные и исследовательские вопросы, которые пока не решены и всё ещё изучаются.
Представители Gonka также сказали, что надеются заинтересовать студентов некоторыми из этих задач и, возможно, привлечь их к исследованиям.
Зачем децентрализовать ИИ?
Анастасия и Глеб начали с базового вопроса: зачем вообще рассматривать децентрализацию ИИ?
«Думаю, если вы находитесь в Беркли в 2026 году, вам вряд ли хочется слушать очередную речь о том, что ИИ становится всё более важной частью нашей жизни. Но он действительно влияет на нашу жизнь. Он влияет на скорость прогресса. Он влияет на то, кто может заниматься исследованиями и кто может получать новые результаты с помощью этих исследований. Поэтому я бы сказала, что доступ к передовым моделям довольно важен», — говорит Анастасия.
По её словам, в случае закрытых моделей ситуация довольно проста: тот, кто контролирует модель, контролирует и доступ к ней, и в определённой степени её ответы.
«Кто контролирует модель, тот контролирует доступ к ней и контролирует результат. Что вообще может быть произведено этой моделью? Есть ли в ней какая-либо цензура? Встраивается ли в ответы реклама? Или, возможно, она настроена так, чтобы обслуживать какую-то пропаганду?
Какой может быть альтернатива? Одна очевидная вещь, которую в последнее время много обсуждают, — модели с открытыми весами».
Анастасия считает, что открытые веса решают часть этих проблем, но тогда контроль в значительной степени переходит от владельцев моделей к тем, кто владеет вычислительными ресурсами.
«Модели с открытыми весами действительно решают часть этих проблем, но скорее переносят контроль от тех, кто владеет моделями, к тем, кто владеет вычислительными ресурсами. Если у вас нет доступа к вычислениям, чтобы запустить свою модель, неважно, что её веса открыты.
Если такая модель с открытыми весами обслуживается на оборудовании, к которому у вас нет доступа, вы просто получаете её от какого-то провайдера, который утверждает, что запускает именно эту open-source модель. На самом деле вы никак не можете проверить, была ли модель изменена, корректировались ли её ответы или, например, вам дали квантованную версию, которая выдаёт результаты гораздо более низкого качества, а провайдер вам об этом не сказал», — говорит Матвеева.
Глеб Моргачёв, в свою очередь, обратил внимание на огромный объём вычислительного оборудования, уже распределённого между множеством независимых владельцев.
«Биткоин-майнеры вместе эксплуатируют дата-центры мощностью более 26 гигаватт. Новый AI-дата-центр Colossus 2 — это всего около одного гигаватта. То есть объём вычислительных мощностей, собранных вместе в Bitcoin, просто огромен. Это больше, чем у OpenAI. Это больше, чем у Meta», — говорит он.
Если применить похожий принцип к оборудованию для ИИ, распределённые вычислительные мощности можно использовать для полезной работы — инференса и обучения моделей. У такой распределённой системы есть и ещё одно важное свойство: ограничить доступ к её вычислениям крайне сложно.
«Что ещё здесь интересно — практически невозможно как-то ограничить доступ к таким вычислительным мощностям. Вы можете сказать OpenAI не обслуживать модели для каких-то людей, и они будут обязаны этого не делать.
Но когда это распределённая сеть, это тысячи разных компаний в разных местах. Некоторые компании полностью анонимны, и никто даже не знает, кто они. Вы блокируете один небольшой дата-центр, но Bitcoin от этого не меняется», — говорит Моргачёв.
Что Gonka хочет с этим делать?
Отвечая на вопрос одного из студентов, Глеб объяснил, что, в отличие от Bitcoin, у децентрализованной AI-сети гораздо более жёсткие требования к оборудованию.
Такая система должна быть способна достаточно быстро обслуживать лучшие open-source модели, оставаться самодостаточной и не зависеть от одной стороны, которая могла бы ограничить доступ или изменить выдачу модели.
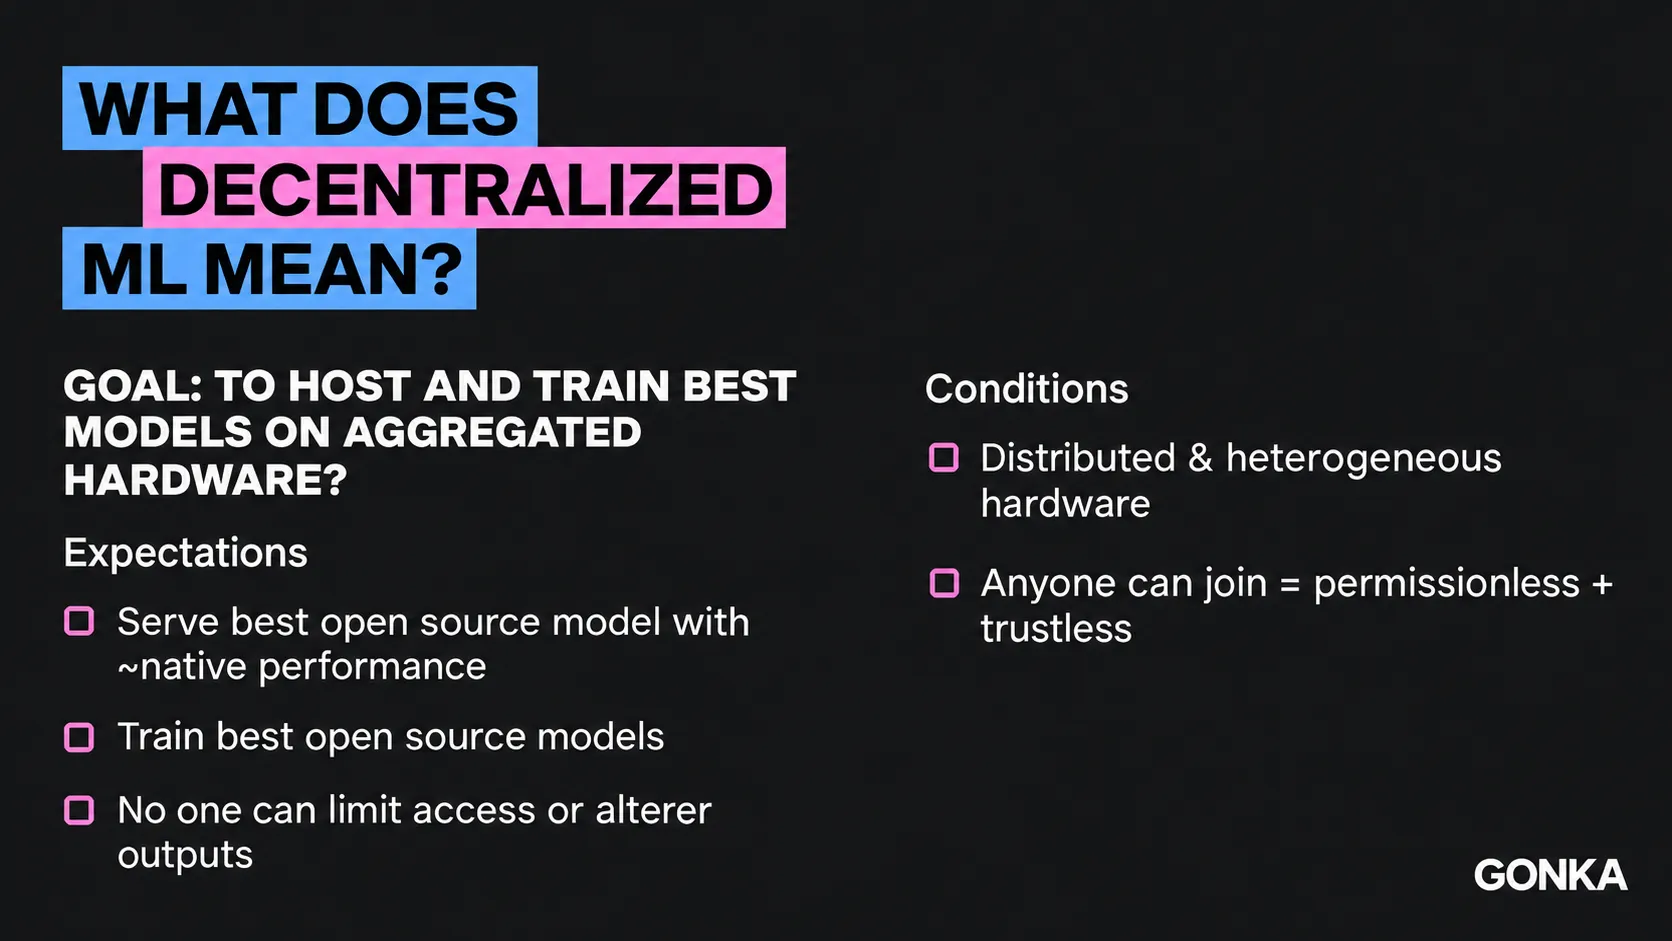
Как Gonka формулирует задачу децентрализованного машинного обучения: распределённое оборудование, открытое участие и работа без необходимости доверять отдельным участникам.
«Оборудование будет распределено по всему миру. Это разные серверы, соединённые через интернет с очень плохим соединением по сравнению с NVLink. Оборудование также будет разнородным — CUDA, AMD, какие-то кастомные ускорители — и мы не можем заранее знать, какое именно оборудование будет использоваться.
Чтобы собрать вместе много оборудования, мы должны позволить любому присоединиться к такой сети и предоставить свои вычислительные ресурсы. То есть сеть должна быть permissionless. Но если мы разрешаем присоединиться кому угодно, не все будут честными. Поэтому такая система также должна быть trustless. Она не должна просто исходить из того, что поставщик оборудования будет честным», — говорит он.
Как построить доверие в системе, где никому нельзя доверять?
По словам команды Gonka, здесь возникает кажущееся противоречие. С одной стороны, сети нужны воспроизводимость и проверяемость. С другой — любой участник системы потенциально может попытаться обмануть её.
Как сеть может решить, чему доверять, если она не может доверять отдельным участникам?
«Это известная проблема из теории игр — византийские генералы. В классической формулировке генералы должны решить, штурмовать город или нет. Большинство из них лояльны, но небольшая группа предателей пытается заставить остальных следовать плану, который приведёт всех к проблемам.
Как решить такую задачу? Все стратегии опираются на предположение, что большинство этих генералов будут честными. Аналогично все децентрализованные системы основаны на предположении о честном большинстве», — объясняет Анастасия Матвеева.
В византийской отказоустойчивости обычно предполагается, что две трети валидаторов честны. Gonka основана на похожем принципе.
«При запуске Gonka мы приняли механизм Proof of Compute — это версия Proof of Work, где вес участников пропорционален вычислительной мощности, измеряемой через инференс модели.
Ключевой момент в том, что он не создаёт значительного объёма бесполезной работы. Фаза бенчмаркинга очень короткая и нужна только для того, чтобы понять мощность. Всё остальное время система обслуживает инференс open-source моделей, о которых договорились участники», — отмечает соосновательница Gonka.
Proof of Compute и модель безопасности
По словам Глеба Моргачёва, задача Proof of Compute — присвоить каждому участнику вес, пропорциональный его вычислительной мощности.
Сеть интересует не абстрактная вычислительная мощность — например, сколько хэшей устройство может посчитать за секунду. Важно именно то, насколько оборудование эффективно для инференса больших языковых моделей. Сюда входит не только сырая вычислительная мощность и операции низкой точности, но и пропускная способность памяти, потому что LLM должны быстро считывать данные из VRAM.
Как это работает?
«Раз в эпоху Proof of Compute проходит в две фазы. Сначала все хосты одновременно генерируют артефакты — очень важно, что они делают это в одно и то же время. Эти артефакты основаны на forward pass большой языковой модели со случайно заданным входом.
В течение пары минут каждый хост производит столько артефактов, сколько может. Затем все хосты начинают проверять других: они выбирают случайную подвыборку артефактов других хостов, повторяют вычисление и проверяют, было ли оно честным или нет.
После этого они голосуют и определяют вес этого хоста на следующую эпоху. Эта процедура занимает около трёх минут, и все приходят к согласию относительно весов на следующие 24 часа», — говорит он.
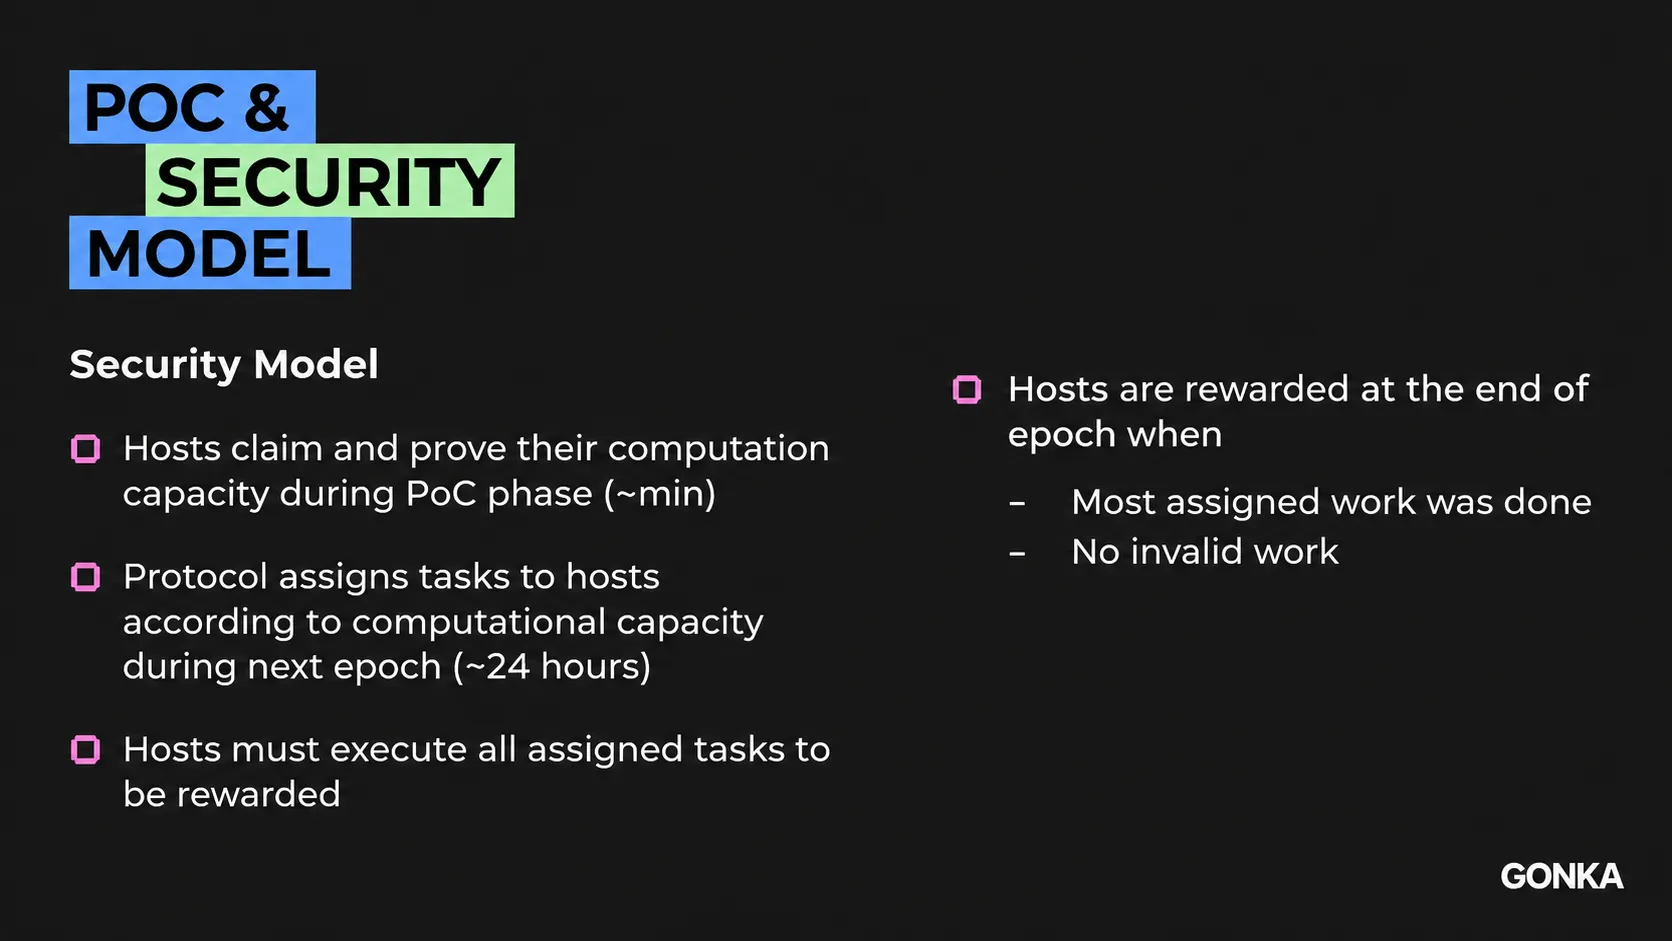
Proof of Compute определяет веса хостов, распределяет работу и связывает вознаграждение с корректным выполнением задач.
Как сеть распределяет работу
Как объяснил Глеб, после завершения Proof of Compute вес хоста используется для распределения реальных задач по сети. Если у одного хоста вес в десять раз больше, чем у другого, он получает примерно в десять раз больше работы. Это не синтетическая работа, созданная только для поддержки протокола. Это реальные пользовательские запросы на инференс и потенциально другие AI-задачи.
«Это реальная задача, а не искусственная. Кто-то приходит в Gonka и говорит: “Я хочу, чтобы мой агент работал на какой-то модели”, — и это действительно задача.
Хост должен выполнить все эти задачи, чтобы получить вознаграждение, и получает его в конце эпохи только после того, как вся работа выполнена», — объясняет Моргачёв.
Здесь возникает ещё одна проблема: сети нужно проверить, что хост действительно обработал запрос с использованием той модели, которую должен был использовать. Просто отправить тот же промпт на другой сервер недостаточно. Вычисления на GPU недетерминированы, а повторный расчёт каждого запроса сделал бы систему слишком дорогой. Поэтому сеть проверяет только случайную подвыборку запросов на инференс. Валидирующий хост повторяет необходимое вычисление для уже известной последовательности токенов и сравнивает полученные распределения вероятностей с исходным результатом.
«На практике сейчас система проверяет не все запросы, а только небольшую часть. Каждый хост выбирает запросы другого хоста и решает, нужно ли их проверять.
Для такого запроса он повторяет инференс с заранее известной последовательностью токенов, получает логарифмы вероятностей для той же последовательности и сравнивает артефакт с исходным артефактом. После этого хост решает, считает ли он инференс валидным или невалидным.
Само голосование происходит только тогда, когда какой-то хост хочет признать другой хост невалидным», — говорит Глеб.
Сеть не пытается определить, является ли ответ «хорошим». Её задача — понять, действительно ли хост использовал ту модель, которую заявил. Например, если хост должен обслуживать модель в FP8, но переключается на FP4-версию, чтобы сэкономить ресурсы, такой инференс должен считаться невалидным.
Помимо проверки отдельных запросов, Gonka также должна удостовериться, что хост действительно предоставляет тот объём вычислительных ресурсов, который заявил. Сеть может отслеживать, справляется ли хост с назначенной ему нагрузкой и отвечает ли вовремя. Участник, который систематически этого не делает, может потерять вознаграждение за эпоху.
Почему одного блокчейна оказалось недостаточно
Ещё одной проблемой, масштаб которой команда Gonka поначалу недооценила, стала масштабируемость. Даже несколько тысяч GPU могут обрабатывать огромное количество запросов. При этом децентрализованной системе нужно фиксировать платежи, начало и завершение запросов, результаты валидации и голоса.
«Когда мы начинали этот протокол, мы не думали, что масштабируемость настолько важна, но потом это стало довольно болезненной проблемой. Даже если у вас всего пара тысяч GPU используется для инференса, вам нужно записывать в сеть миллионы транзакций только для голосования и биллинга — запрос начался, запрос завершился и так далее.
Как выяснилось, ни один децентрализованный протокол не может таким образом обрабатывать столько транзакций», — говорит Моргачёв.
Одно из решений Gonka — система небольших временных децентрализованных сетей, создаваемых для отдельных взаимодействий с протоколом.
«Когда пользователь хочет взаимодействовать с протоколом и использовать инференс, он создаёт escrow и открывает небольшую независимую децентрализованную сеть — маленький независимый блокчейн, который живёт только следующие несколько часов.
Если у нас тысяча пользователей, это тысяча небольших временных блокчейнов. Это может масштабироваться линейно, и работает довольно хорошо», — говорит Глеб.
Можно ли обучать модели через интернет?
После обсуждения инференса сооснователи Gonka перешли к более долгосрочной задаче — распределённому обучению моделей. Анастасия отметила, что для запуска модели может быть достаточно нескольких GPU, тогда как для обучения модели того же масштаба традиционно требуется намного больше ускорителей, расположенных в одном дата-центре и связанных высокоскоростной сетью.
«Как мы можем делать это без огромного дата-центра, без этого сверхбыстрого соединения между GPU, находящимися в одном дата-центре, и при этом добиться сопоставимой производительности и не потерять в качестве итоговой модели?
Как сделать обучение через интернет возможным? Это большой, интересный, открытый исследовательский вопрос», — говорит Матвеева.
Один из подходов, обсуждавшихся на лекции, — DiLoCo, Distributed Low-Communication Training от Google DeepMind. Основная идея состоит в том, чтобы синхронизировать результаты разных участников значительно реже: часть обучения происходит локально, а результаты периодически агрегируются.
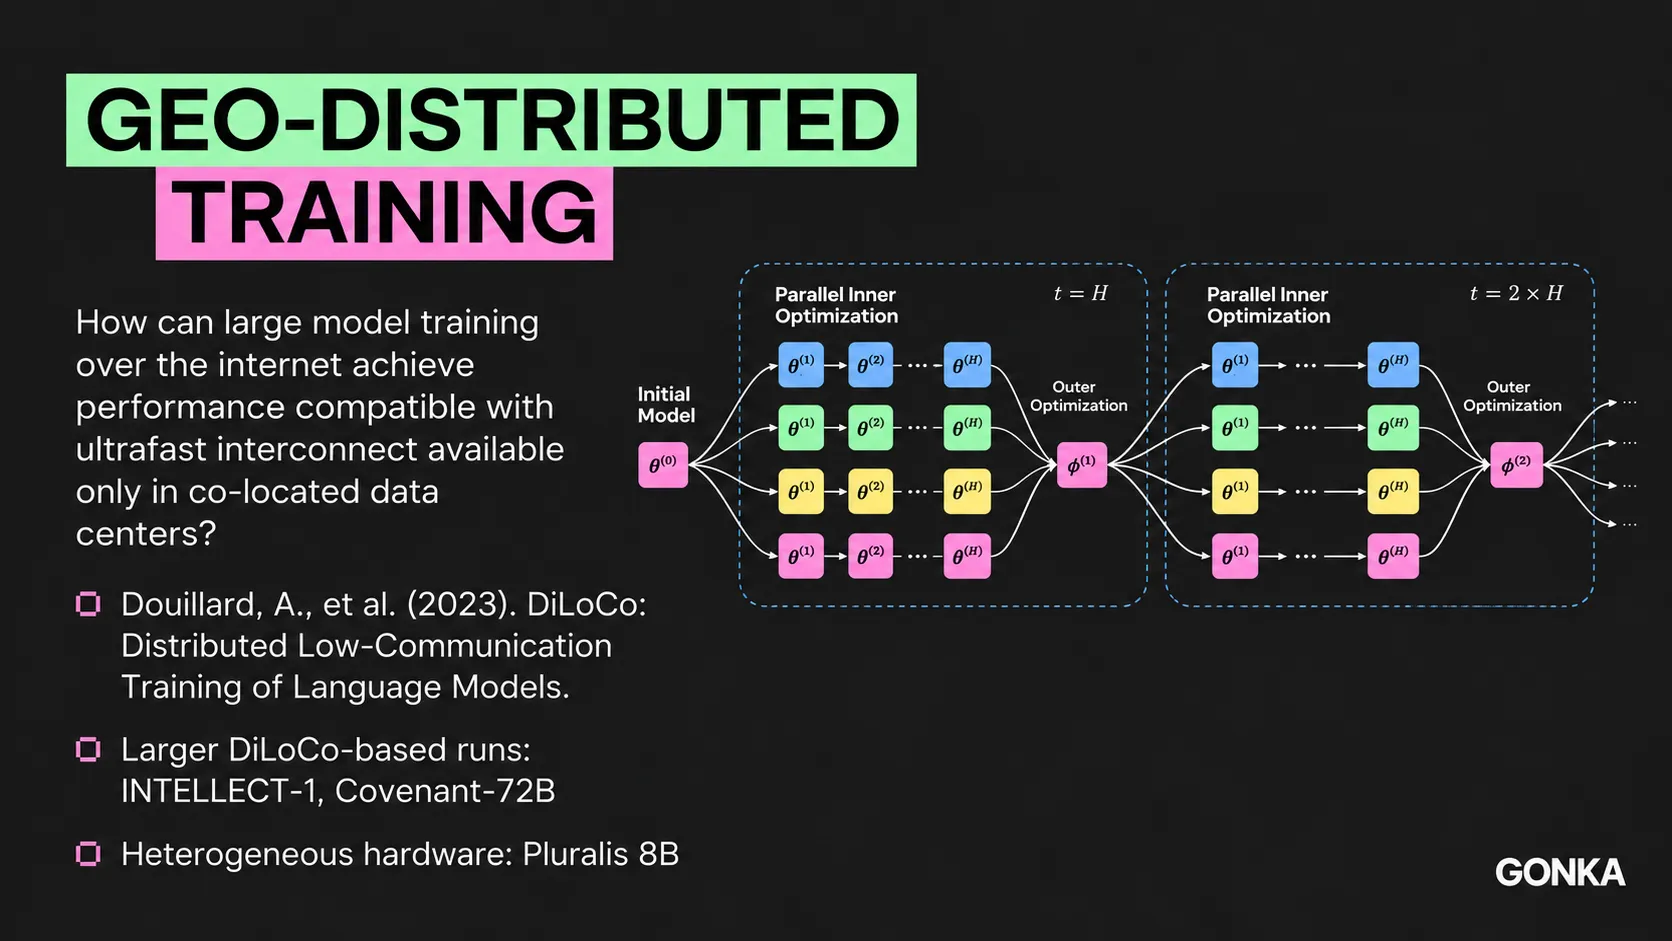
DiLoCo обсуждался как один из подходов к обучению моделей на географически распределённом оборудовании.
«В работе DiLoCo исследовался подход, при котором число коммуникационных шагов сокращается, а процесс разбивается на цикл обучения: есть внутренний оптимизатор, который каждый участник использует локально, и гораздо более редкие шаги, когда результаты, отдельно посчитанные всеми участниками, действительно агрегируются.
То есть вы распараллеливаете обучение, но всё равно сохраняете шаги, охватывающие всех участников. Результаты показывают, что качество моделей, полученных таким образом, действительно достигает бенчмарков моделей аналогичного размера, обученных централизованно на совместно размещённом оборудовании», — объясняет Анастасия.
По словам представителей Gonka, это направление уже проверяется на практике другими командами. Среди упомянутых проектов был Prime Intellect. Для децентрализованной сети также важно, что набор участвующих GPU не обязательно должен оставаться неизменным. Участник может предоставить вычислительные ресурсы для части обучения, а затем уйти, в то время как другие продолжат процесс.
Как обучать модель, если некоторым участникам нельзя доверять?
Как подчеркнули сооснователи Gonka, распределение обучения через интернет решает только часть проблемы. В trustless-системе нельзя просто предполагать, что каждый участник честно выполняет заявленные вычисления. Последствия могут быть потенциально серьёзнее, чем в случае отдельного запроса на инференс: вредоносные или ошибочные обновления способны повлиять на весь процесс обучения.
По словам Анастасии, цель Byzantine-tolerant обучения не обязательно в том, чтобы выявить каждого вредоносного участника. Гораздо важнее обеспечить, чтобы модель продолжала сходиться даже при наличии плохих обновлений.
«Цель не только в том, чтобы найти таких участников или полностью избежать некорректных отправок, потому что это тоже было бы невозможно. Цель — гарантировать, что в итоге ваша модель сойдётся к тому же результату, к которому она сошлась бы в честном сценарии.
Даже если какой-то процент обновлений потенциально вредоносный или просто случайно неправильный, честные обновления должны продолжать улучшать модель и вести её к сходимости, а ошибочные обновления не должны доминировать в процессе агрегации», — говорит она.
Это по-прежнему открытая исследовательская проблема. Участников нужно проверять достаточно часто, чтобы защитить процесс обучения, но не настолько часто, чтобы дополнительная вычислительная нагрузка делала распределённое обучение неэффективным. Спикеры также отметили, что техническая проверка — только часть картины: экономические стимулы, включая вознаграждения и штрафы, могут влиять на то, имеет ли смысл для участников пытаться обманывать систему.
Что, если использовать много небольших моделей вместо одной огромной?
В конце основной части лекции команда Gonka обсудила ещё одно исследовательское направление: использование множества меньших моделей, взаимодействующих друг с другом, вместо постоянных попыток строить одну очень большую модель. Один из подходов предполагает, что небольшие модели обмениваются не только текстом, как это обычно делают AI-агенты сегодня, но и своими внутренними состояниями. Для децентрализованного ИИ это особенно интересно, потому что может существенно снизить требования к оборудованию отдельных участников.
«Все эти вещи важны для децентрализованного мира, потому что, как только появятся хорошие результаты и в обучении взаимодействующих небольших моделей, и в инференсе таких моделей, в децентрализованной сети можно будет использовать не только оборудование уровня дата-центров — можно будет использовать даже телефон.
Если модель с одним миллиардом параметров становится действительно ценной, взаимодействуя с тысячами других моделей по одному миллиарду параметров, серьёзные вычисления смогут происходить у нас в карманах. Думаю, это одна из больших целей того, как всё это может стать по-настоящему децентрализованным», — говорит Глеб.
В конце основной презентации сооснователи подчеркнули, что многие из обсуждавшихся направлений всё ещё остаются открытыми исследовательскими задачами. В то же время дискуссия была не только теоретической: инференс уже работает, а упомянутые во время лекции запуски распределённого обучения действительно проводились.
Вопросы студентов Беркли
Что такое артефакт в Proof of Compute Gonka?
Артефакт используется в Proof of Compute, чтобы проверить, действительно ли хост выполнил требуемое вычисление. Nonce — целочисленное значение — используется для определения входа модели. Во время вычисления в LLM добавляется несколько небольших случайных слоёв, а на выходе — дополнительный случайный линейный слой. Полученный артефакт представляет собой небольшой многомерный вектор. Вместе с входным nonce он позволяет сети проверить вычисление от начала до конца.
Проблема в том, что вычисления на GPU недетерминированы, особенно на разнородном оборудовании. Нельзя просто повторить то же вычисление и ожидать абсолютно идентичного результата. Поэтому проверка должна быть статистической: артефакты сравниваются с помощью метрики, которая позволяет определить, является ли результат валидным.
Как выбираются случайные параметры для проверки?
Начальный seed берётся из хэша блока, который запускает процедуру Proof of Compute. Для генерации финального seed конкретного хоста к нему добавляются публичный ключ хоста и nonce. К моменту начала валидации эти seed уже известны.
Валидатор может, например, выбрать 100 артефактов из 10 000, запросить полные артефакты у другого хоста и повторить соответствующее вычисление.
Зачем Proof of Compute использует случайные слои?
Это небольшие дополнительные слои, которые модель не использует вне Proof of Compute. Они затрудняют участнику возможность специально оптимизироваться под бенчмарк или заменить полную модель на меньшую distilled-версию. Таким образом, рандомизация выступает дополнительным уровнем защиты.
Как защищаются данные пользователей?
В текущей архитектуре сервер, выполняющий пользовательский инференс, технически может получить доступ к данным, находящимся в его памяти. То же самое может относиться к другому хосту, если ему нужно повторить запрос в рамках валидации. Сами разработчики протокола автоматически не получают доступ к пользовательским данным, если только они сами не управляют хостом.
Один из потенциальных вариантов, упомянутых представителями Gonka, — trusted execution environment (TEE), которая может защищать данные даже от оператора сервера. Другой вариант — использование публично идентифицируемых корпоративных хостов, способных брать на себя договорные обязательства относительно хранения и удаления данных.
Как защитить распределённое обучение от нечестных участников?
Сейчас в сети нет полностью готового Byzantine-tolerant механизма для обучения. Во время тестнета команда экспериментировала с Proof of Learning. Хосты должны были сохранять результаты некоторых случайно выбранных шагов градиента, которые позднее мог запросить и пересчитать другой участник.
Такой подход позволял обнаруживать хосты, которые на самом деле не выполняли работу, но требовал хранения очень больших объёмов данных. Спикеры описали его как теоретически привлекательный, но пока непрактичный.
Почему инференс в Gonka сейчас такой дешёвый?
Вознаграждение хостов сейчас поступает из двух основных источников: наград, создаваемых самим протоколом, и платежей пользователей за инференс. На данном этапе протокольные награды значительно превышают пользовательские комиссии. Иными словами, пользователи пока платят недостаточно, чтобы полностью покрывать стоимость оборудования, предоставляемого хостами. Значительная часть компенсации хостов поступает непосредственно от протокола за предоставление вычислительной мощности.
Изначально команда также рассматривала динамическое ценообразование: при высокой загрузке сети цены должны были расти, а при низкой — снижаться, помогая балансировать спрос и доступные вычислительные ресурсы. По словам спикеров, сейчас этот механизм on-chain не работает.
Как Gonka может учитывать регуляторные требования?
Один из студентов описал сценарий, при котором законодательство требует от AI-провайдера блокировать определённые категории запросов. Представители Gonka указали на фундаментальное отличие децентрализованной сети: здесь нет единого провайдера инференса. Сеть состоит из независимых хостов, работающих в разных странах, и каждый из них может быть обязан соблюдать собственные локальные требования. Если компания перепродаёт инференс Gonka в конкретной стране, она может реализовать необходимые ограничения на уровне собственного сервиса.
Если правило должно применяться ко всей сети, это уже становится вопросом governance: участникам необходимо договориться об изменении и соответствующим образом обновить программное обеспечение или модели. При этом текущая система валидации Gonka не анализирует содержание пользовательских запросов. Её задача — проверить, действительно ли хост использовал заявленную модель.
Почему проект называется Gonka?
Название происходит от русского слова «гонка», то есть «race». Спикеры объяснили, что в команде Gonka много русскоязычных людей, а само название также отражает идею Proof of Compute. В некотором смысле участники соревнуются в оптимизации своего оборудования — настраивают его под конкретную модель и пытаются обслуживать инференс максимально эффективно.
Таким образом, Gonka — это не только отсылка к русскому слову, но и к соревнованию вокруг оптимизации оборудования, встроенному в механизм Proof of Compute.
Your support helps keep the blog independent
It helps us spend more time on analysis and original stories about the network.